

意朗本地AI智能体建设第三期
前言
前两期,我们聊了两个问题。
第一期,我们讨论了:
企业上AI,真的只是打开一个聊天窗口吗?
答案显然不是。
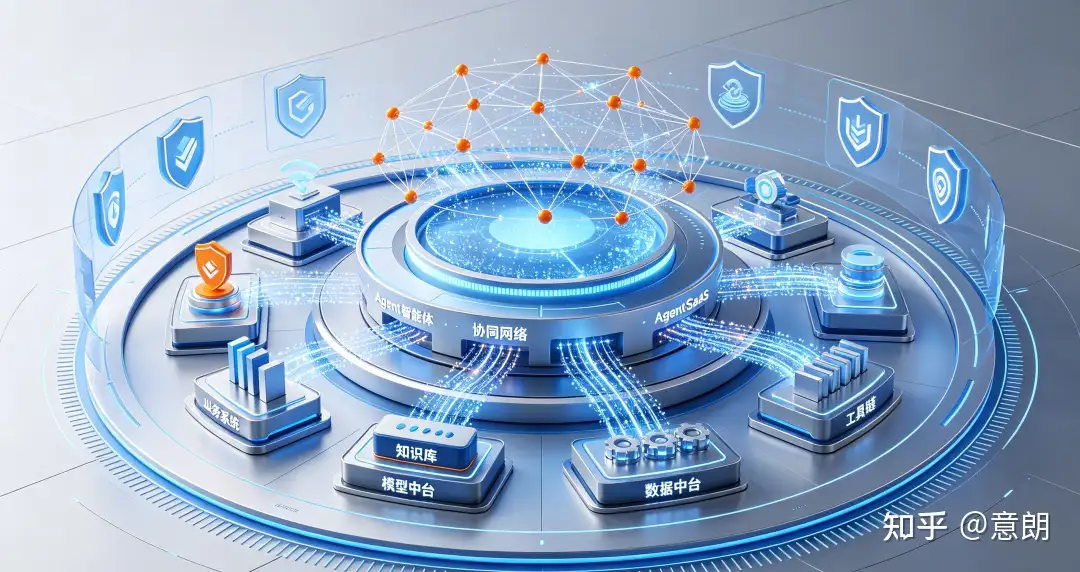
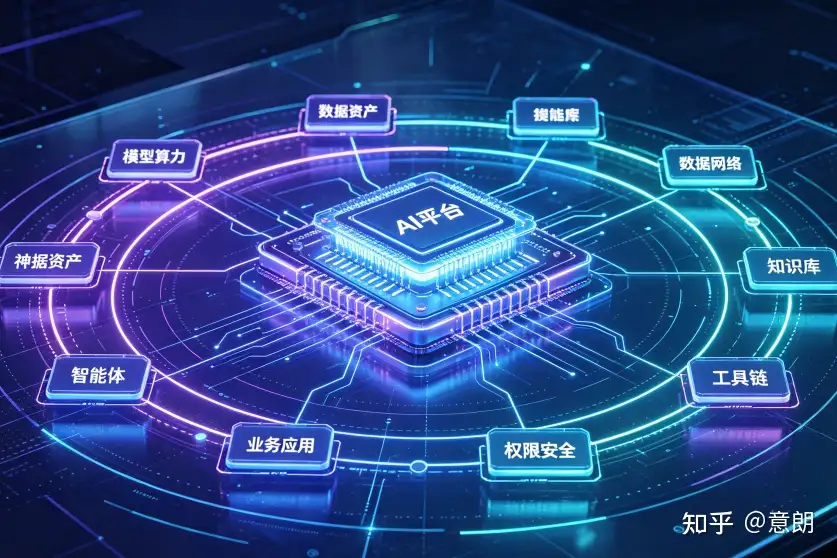
企业真正的AI体系,需要模型、数据、知识库、Agent、工具、业务系统、权限和安全体系共同构成。
第二期,我们又聊了一个更加具体的问题:
数字员工,到底应该是一个“全才”,还是一支“班底”?
我们的答案是:
与其打造一个什么都会的超级Agent,不如根据企业实际业务,建立职责清晰、权限明确、能够相互协作的数字员工体系。
那么问题来了:
如果这些都明白了,一家普通制造企业真正开始做AI的时候,第一步到底应该做什么?
这一次,我们不再谈太多概念。
直接从意朗自己的实践开始。
Part1
企业AI,第一步不是“买模型”
很多企业开始做AI,第一反应往往是:
买服务器。
买GPU。
买模型。
部署一个AI平台。
然后开始研究:
“到底哪个模型最强?”
但真正开始建设以后,我们发现:
模型反而不是最先需要解决的问题。
因为一个企业即使拥有最先进的大模型,如果不知道让它做什么,它依然只是一个非常聪明的聊天工具。
所以我们在实际建设过程中,首先问的并不是:
“我们要用什么模型?”
而是:
“我们准备让AI先解决哪一个真实的问题?”
这两个问题看起来很接近,实际上完全不同。
前一个问题是技术问题。
后一个问题,是企业业务问题。
而企业AI真正的起点,恰恰应该是后者。
Part2
不要一开始就做“AI公司”
这是我们在实践过程中逐渐形成的一个认识。
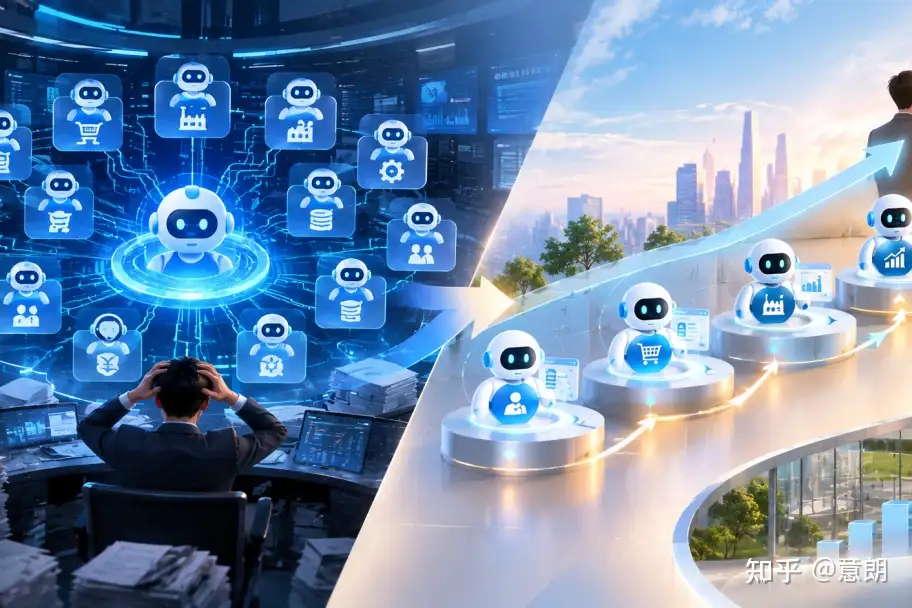
如果企业刚开始建设AI,就准备一次性完成:
销售Agent、采购Agent、生产Agent、技术Agent、财务Agent、行政Agent、客服Agent……
然后再建立一个总Agent统一管理几十个Agent。
从架构图上看,当然非常漂亮。
但真正做起来,很容易变成:
架构已经完成,业务却没有真正跑起来。
原因很简单。
Agent数量增加以后,需要同步解决:
知识库。
权限。
数据。
工具。
接口。
任务调度。
日志。
异常处理。
人员协作。
每增加一个Agent,实际上都可能增加一套新的维护工作。
所以我们更倾向于另一种方式:
先做一个真正有价值的数字员工。
让它跑起来。
让它解决真实工作。
发现问题。
修改问题。
再逐步增加第二个、第三个。
最终形成完整的数字员工体系。
这其实和企业本身的发展过程非常像。
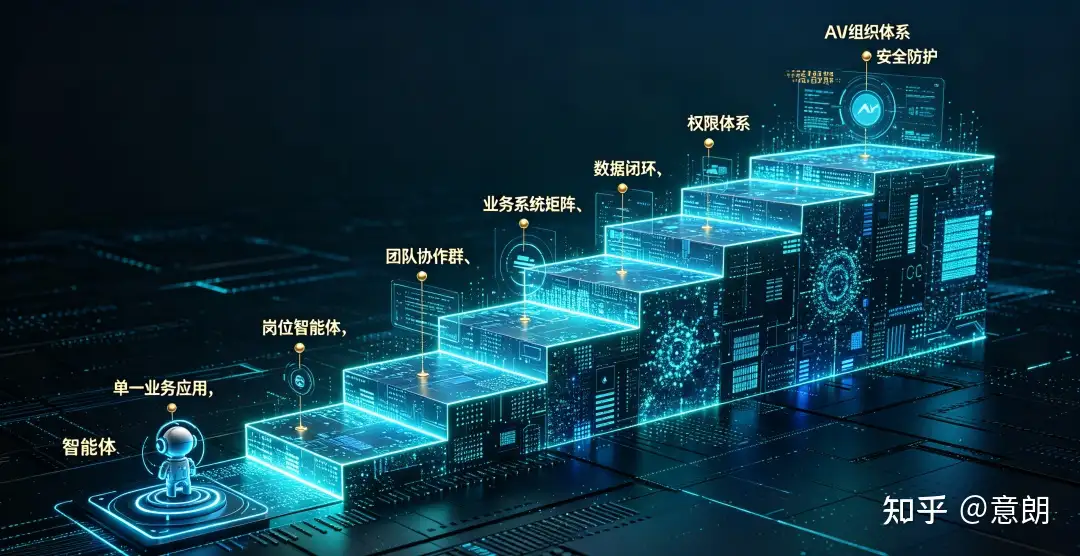
没有哪家公司一开始就拥有完整的组织体系。
都是从一个业务、一个岗位、一个团队逐步发展起来的。
AI也一样。
Part3
第一个数字员工,应该做什么?
这个问题其实比“用什么模型”更加重要。
因为第一个Agent选得好不好,会直接影响企业后续对AI的判断。
如果第一个Agent选择了一个非常复杂、跨部门、跨系统的任务,那么第一次失败的概率可能很高。
最后很容易得出一个结论:
“AI不靠谱。”
但问题可能根本不在AI。
而在于:
第一次就给AI安排了一项它还不适合完成的工作。
所以第一个数字员工,更适合从几个特点明显的任务开始:
重复性比较高。
规则相对明确。
资料比较集中。
人工工作量比较大。
结果容易检查。
失败成本相对较低。
并且能够真正节省人的时间。
例如:
企业内容整理。
企业知识查询。
销售资料整理。
产品资料匹配。
数据统计。
标准报告生成。
内部信息检索。
这些任务虽然看起来没有“全自动接管订单”那么震撼,但却非常适合作为企业AI的第一步。
Part4
我们为什么要先做“岗位”,而不是先做“模型”?
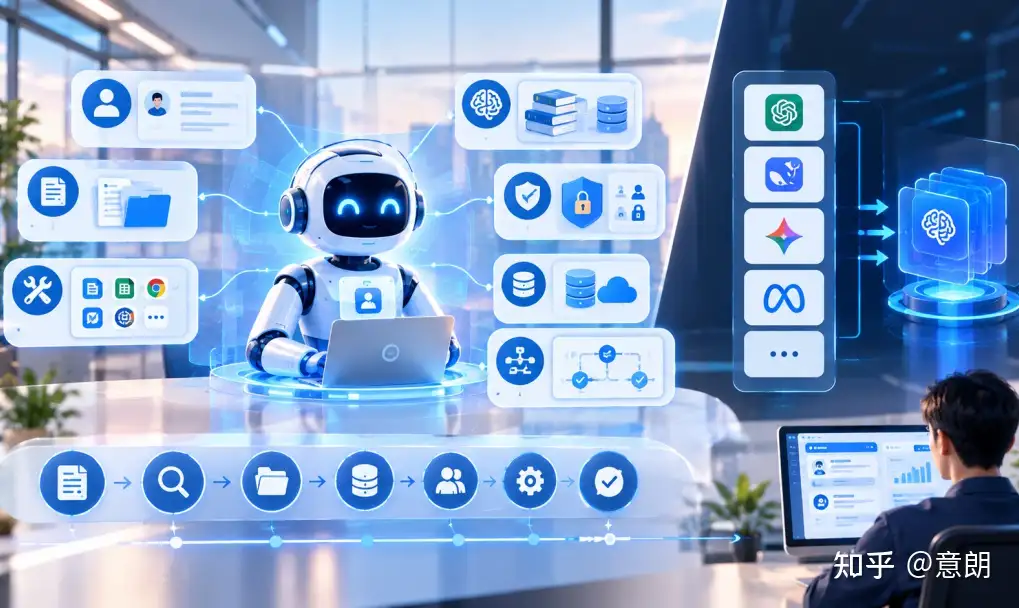
因为企业真正需要的不是一个模型。
而是一个:
能够承担工作的角色。
例如:
如果我们要建立一个内容数字员工。
我们首先定义的不是:
“使用DeepSeek还是其他模型。”
而应该先定义:
它是谁?
它负责什么?
它不负责什么?
它需要什么知识?
它可以使用什么工具?
它能够访问哪些数据?
什么情况下必须交给人工?
什么结果才算完成?
这几个问题回答清楚以后,模型反而变成了一个可以替换的技术组件。
今天可以使用模型A。
明天可以换成模型B。
甚至不同任务使用不同模型。
但这个数字员工的:
职责、知识、工具、权限和工作流程,
不会因为模型更换就全部推倒重来。
这也是我们认为企业AI建设和普通聊天AI使用之间一个很重要的区别。
Part5
一个Agent,到底应该怎么设计?
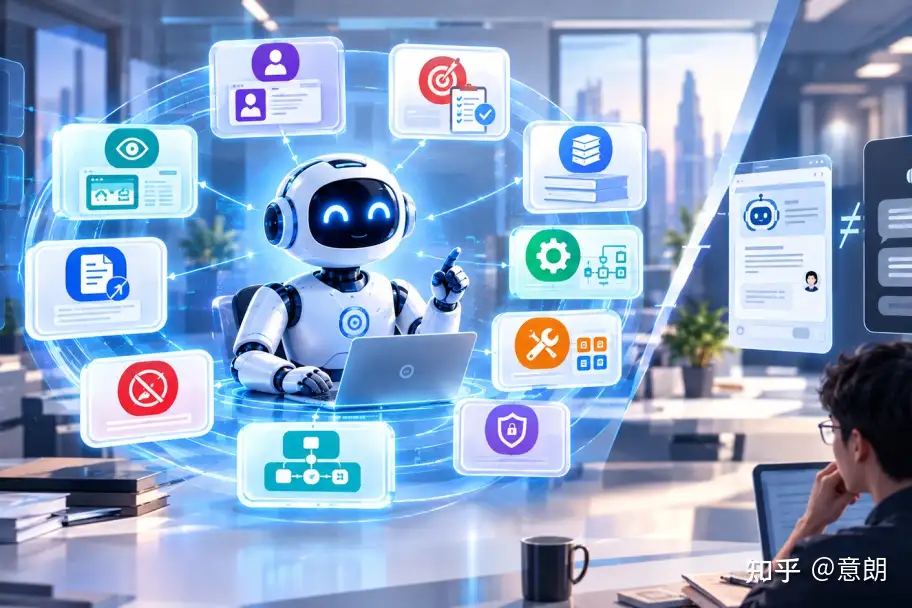
我们目前更倾向于把一个数字员工拆成几个基本部分:
角色。
它是谁,负责什么。
目标。
它最终需要完成什么事情。
知识。
它需要知道什么。
Skill。
它具体会做什么。
工具。
它可以调用什么系统和能力。
权限。
它能够看到什么、操作什么。
流程。
它应该按照什么顺序完成任务。
边界。
哪些事情绝对不能自己决定。
输出。
最终应该把什么结果交给人。
把这些东西定义清楚,一个Agent才真正开始具有“员工”的感觉。
否则,很多所谓的Agent,本质上依然只是:
一个配置了更长提示词的聊天机器人。
Part6
Skill为什么如此重要?
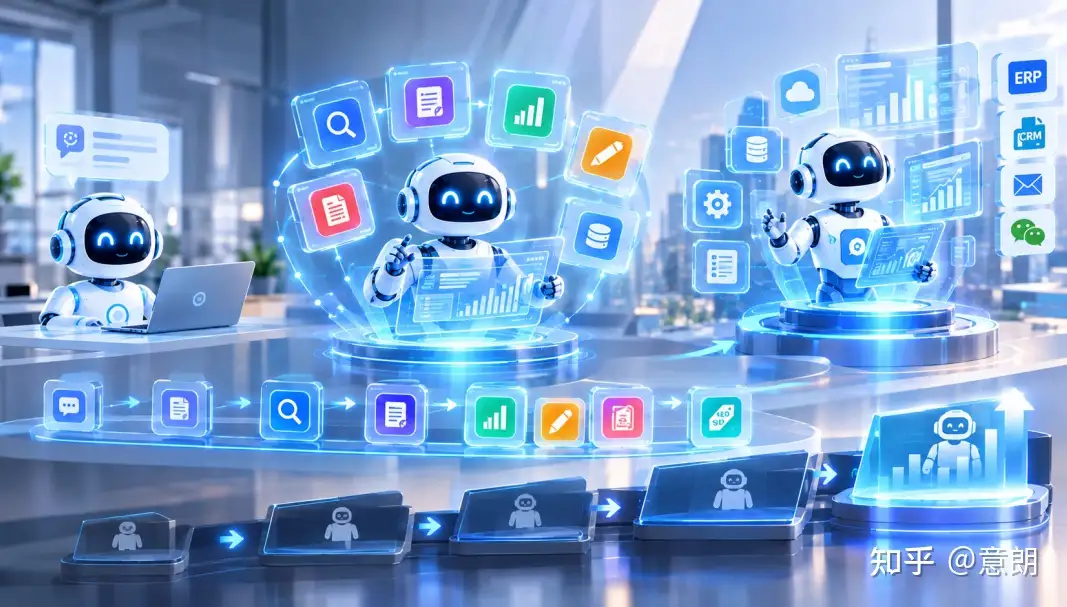
第二期我们已经简单聊过Agent和Skill。
这一期可以进一步往下拆。
如果把Agent看成一个员工,那么Skill就是它真正掌握的工作能力。
比如一个市场数字员工,它可能拥有:
搜索资料的Skill。
分析关键词的Skill。
整理行业信息的Skill。
生成文章的Skill。
制作报告的Skill。
数据分析的Skill。
SEO分析的Skill。
这些能力并不一定全部写死在Agent里面。
更合理的方式,是让Agent根据任务调用不同Skill。
这样做有一个非常现实的好处:
能力可以不断增加,而岗位本身不需要不断重做。
今天它只会写文章。
明天增加数据分析Skill。
后天增加搜索Skill。
再增加企业知识库查询Skill。
最后再连接业务系统。
它就会逐渐从一个简单的AI助手,变成真正能够承担工作的数字员工。
Part7
但“会做事”还不够
这里还有一个容易被忽略的问题。
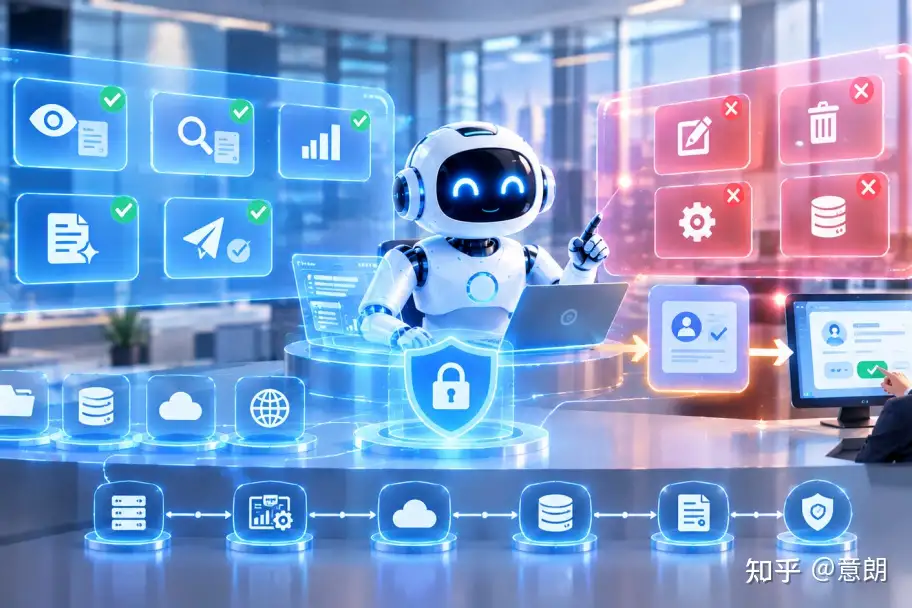
如果一个Agent什么都可以调用,实际上并不一定是一件好事。
例如:
市场Agent可以查看所有客户资料。
销售Agent可以修改ERP订单。
生产Agent可以查看财务数据。
技术Agent可以修改产品数据库。
这样的系统,即使AI能力很强,也存在明显的管理风险。
所以我们在设计数字员工的时候,需要同时定义:
它能做什么。
以及:
它不能做什么。
例如:
可以读取。
可以搜索。
可以分析。
可以生成。
可以提交。
但不能直接修改。
或者:
可以修改草稿。
但最终提交必须人工确认。
这就是企业AI非常重要的一层:
权限与审批。
未来真正成熟的企业Agent,不应该只是“能不能完成任务”,还必须知道:
什么任务可以自己完成,什么任务必须请示人。
Part8
第一个Agent跑起来以后,真正麻烦的事情才开始
很多人以为:
Agent配置完成。
模型接好了。
知识库接好了。
然后就结束了。
实际上恰恰相反。
真正运行以后,你会开始发现各种问题。
为什么它找不到资料?
为什么它找到了错误的资料?
为什么同一个问题每次回答不一样?
为什么它调用了错误的Skill?
为什么任务执行到一半停了?
为什么某个文件解析失败?
为什么权限判断不正确?
为什么它明明知道答案,却没有按照公司的流程执行?
这些问题都会出现。
所以企业AI建设不是:
配置一次 → 永久使用。
而是:
部署 → 测试 → 发现问题 → 修正 → 再测试 → 上线 → 持续优化。
这其实已经进入了一个新的领域:
Agent工程。
企业AI真正的建设,可能从来都不是一个“大项目”。
它更像是企业内部一次持续发生的变化。
从一个问题开始。
从一个岗位开始。
从一个Agent开始。
从一个真正能够解决问题的工作开始。
然后不断增加能力、连接数据、接入系统、建立协作。
最终形成一套属于企业自己的:
数字员工体系。
而这,也是意朗目前正在尝试的路线。
我们不急着证明AI可以替代多少人。
我们更想知道的是:
一个真实制造企业,究竟能够让AI真正承担多少工作。
这件事情,可能比“AI能不能替代员工”更值得研究。
因为未来真正改变企业的,未必是某一个超级AI。
而可能是:
一群知道自己该做什么、拥有什么权限、掌握什么知识,并且能够彼此协作的数字员工。
这里是意朗本地AI智能体建设系列第三期。
下一期,我们准备再往前走一步:
一个真正的数字员工,到底需要哪些“能力”?
Agent、Skill、知识库、工具、记忆、权限、工作流……
这些东西到底应该怎么组合?
写在最后:意朗为什么要自己做这件事?
对意朗来说,企业AI不是一个展示技术的项目,而是一场真正面向企业未来生产方式的探索。
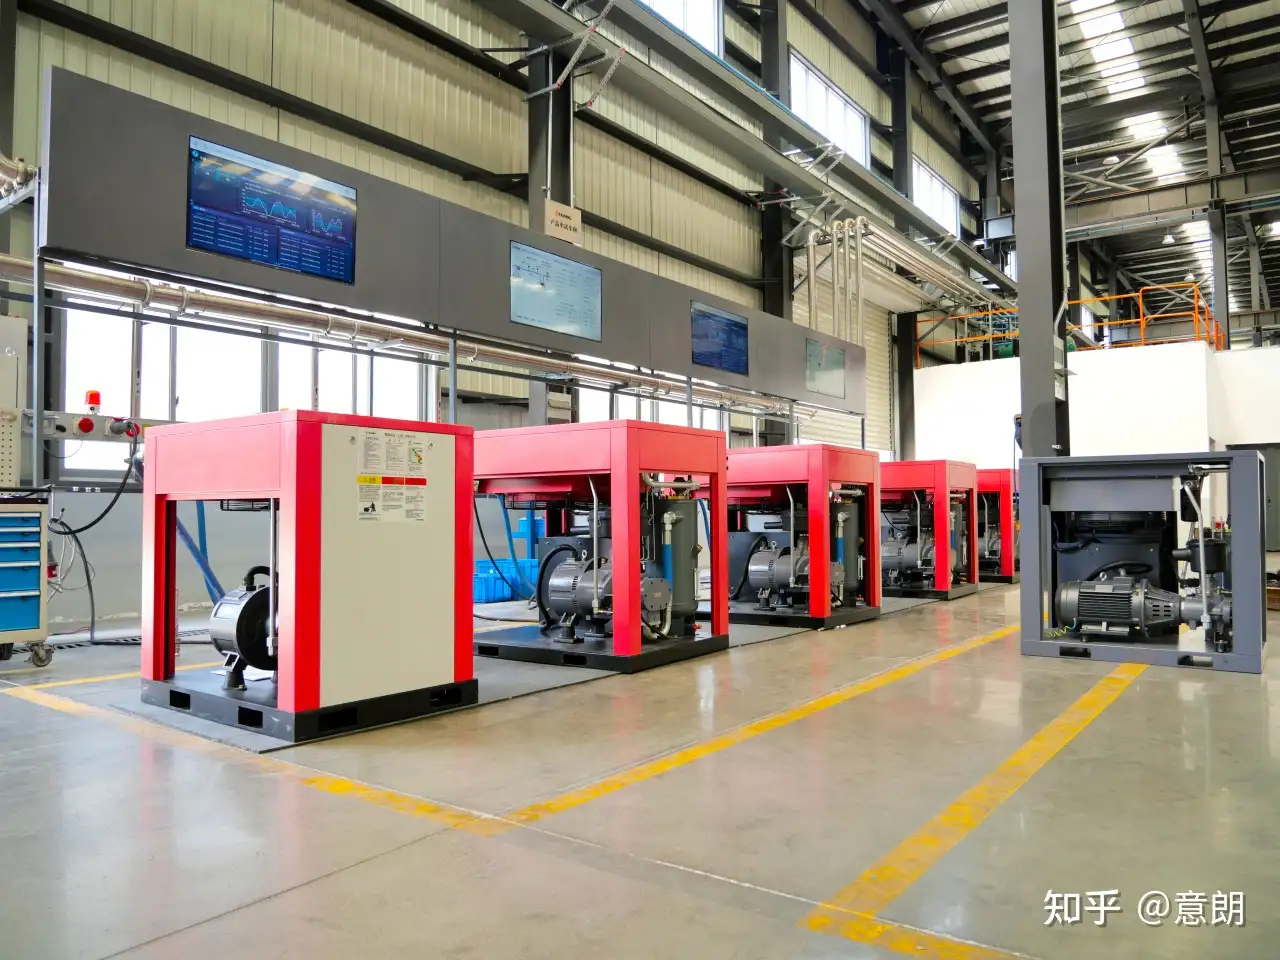
意朗智能科技(南通)有限公司,长期专注于压缩空气动力解决方案,持续推进产品研发、生产制造与数字化建设。面对AI快速发展,我们没有把它简单理解成一个聊天工具,而是从企业自身业务出发,探索将AI与企业知识、产品资料、业务流程、数据系统以及数字员工逐步连接起来。
从一个Agent开始,从一个真实业务场景开始,让AI真正进入工作,而不是停留在聊天窗口。
意朗,让AI真正进入企业。
意智造,朗全球。
意朗智能科技(南通)有限公司
为高端制造企业提供更可靠的压缩空气动力解决方案